Sviluppatori e integratori API
Integra via MiniMax API (`MiniMax-H3`), Vercel AI Gateway, fal.ai o self-host dei pesi aperti. Un'unica architettura gestisce T2V, I2V, reference e editing.
MiniMax H3 è un sistema generativo omni-modale general-purpose — un modello da 33B parametri che comprende testo, immagini, video e audio in contesto unificato, generando video 2K con suono stereo nativo in un singolo forward pass.
MiniMax H3 rompe il dominio del closed-source con pesi aperti, rapporto prezzo-prestazioni leader del settore e architettura di generalizzazione dei task per l'ecosistema aperto.
I pesi H3-Base sono pubblicati su Hugging Face sotto la MiniMax Community License — uso commerciale per organizzazioni con fatturato inferiore a $20M. Crea versioni personalizzate su diversi hardware IA.
Un Transformer denso single-stream da 33B parametri con ~20B parametri attivi in inferenza. Usa Qwen3-VL-32B come encoder, 3D multimodal RoPE e separa il compute comprensione/generazione per un 30% di throughput di training in più.
Il linguaggio funge da ponte unificando i task in forma aperta e descrittiva. Descrivi le relazioni tra contesto multimodale e video target in linguaggio naturale — H3 gestisce la comprensione full-modality.
Invece della super-resolution convenzionale, H3 rigenera il proprio output 768p in-context a 2K — recuperando dettagli fini come testo piccolo che gli upscaler non possono ripristinare.
Segui questi passaggi per iniziare a generare con MiniMax H3 usando il generatore di questa pagina o la MiniMax API.
Seleziona text-to-video per generazione solo prompt, first/last-frame per image-to-video, o reference-to-video per workflow omni-reference con fino a 12 file di input misti.
MiniMax H3 serve sviluppatori, studi e creator che necessitano di video IA aperto, controllabile e production-grade con comprensione multimodale.
Integra via MiniMax API (`MiniMax-H3`), Vercel AI Gateway, fal.ai o self-host dei pesi aperti. Un'unica architettura gestisce T2V, I2V, reference e editing.
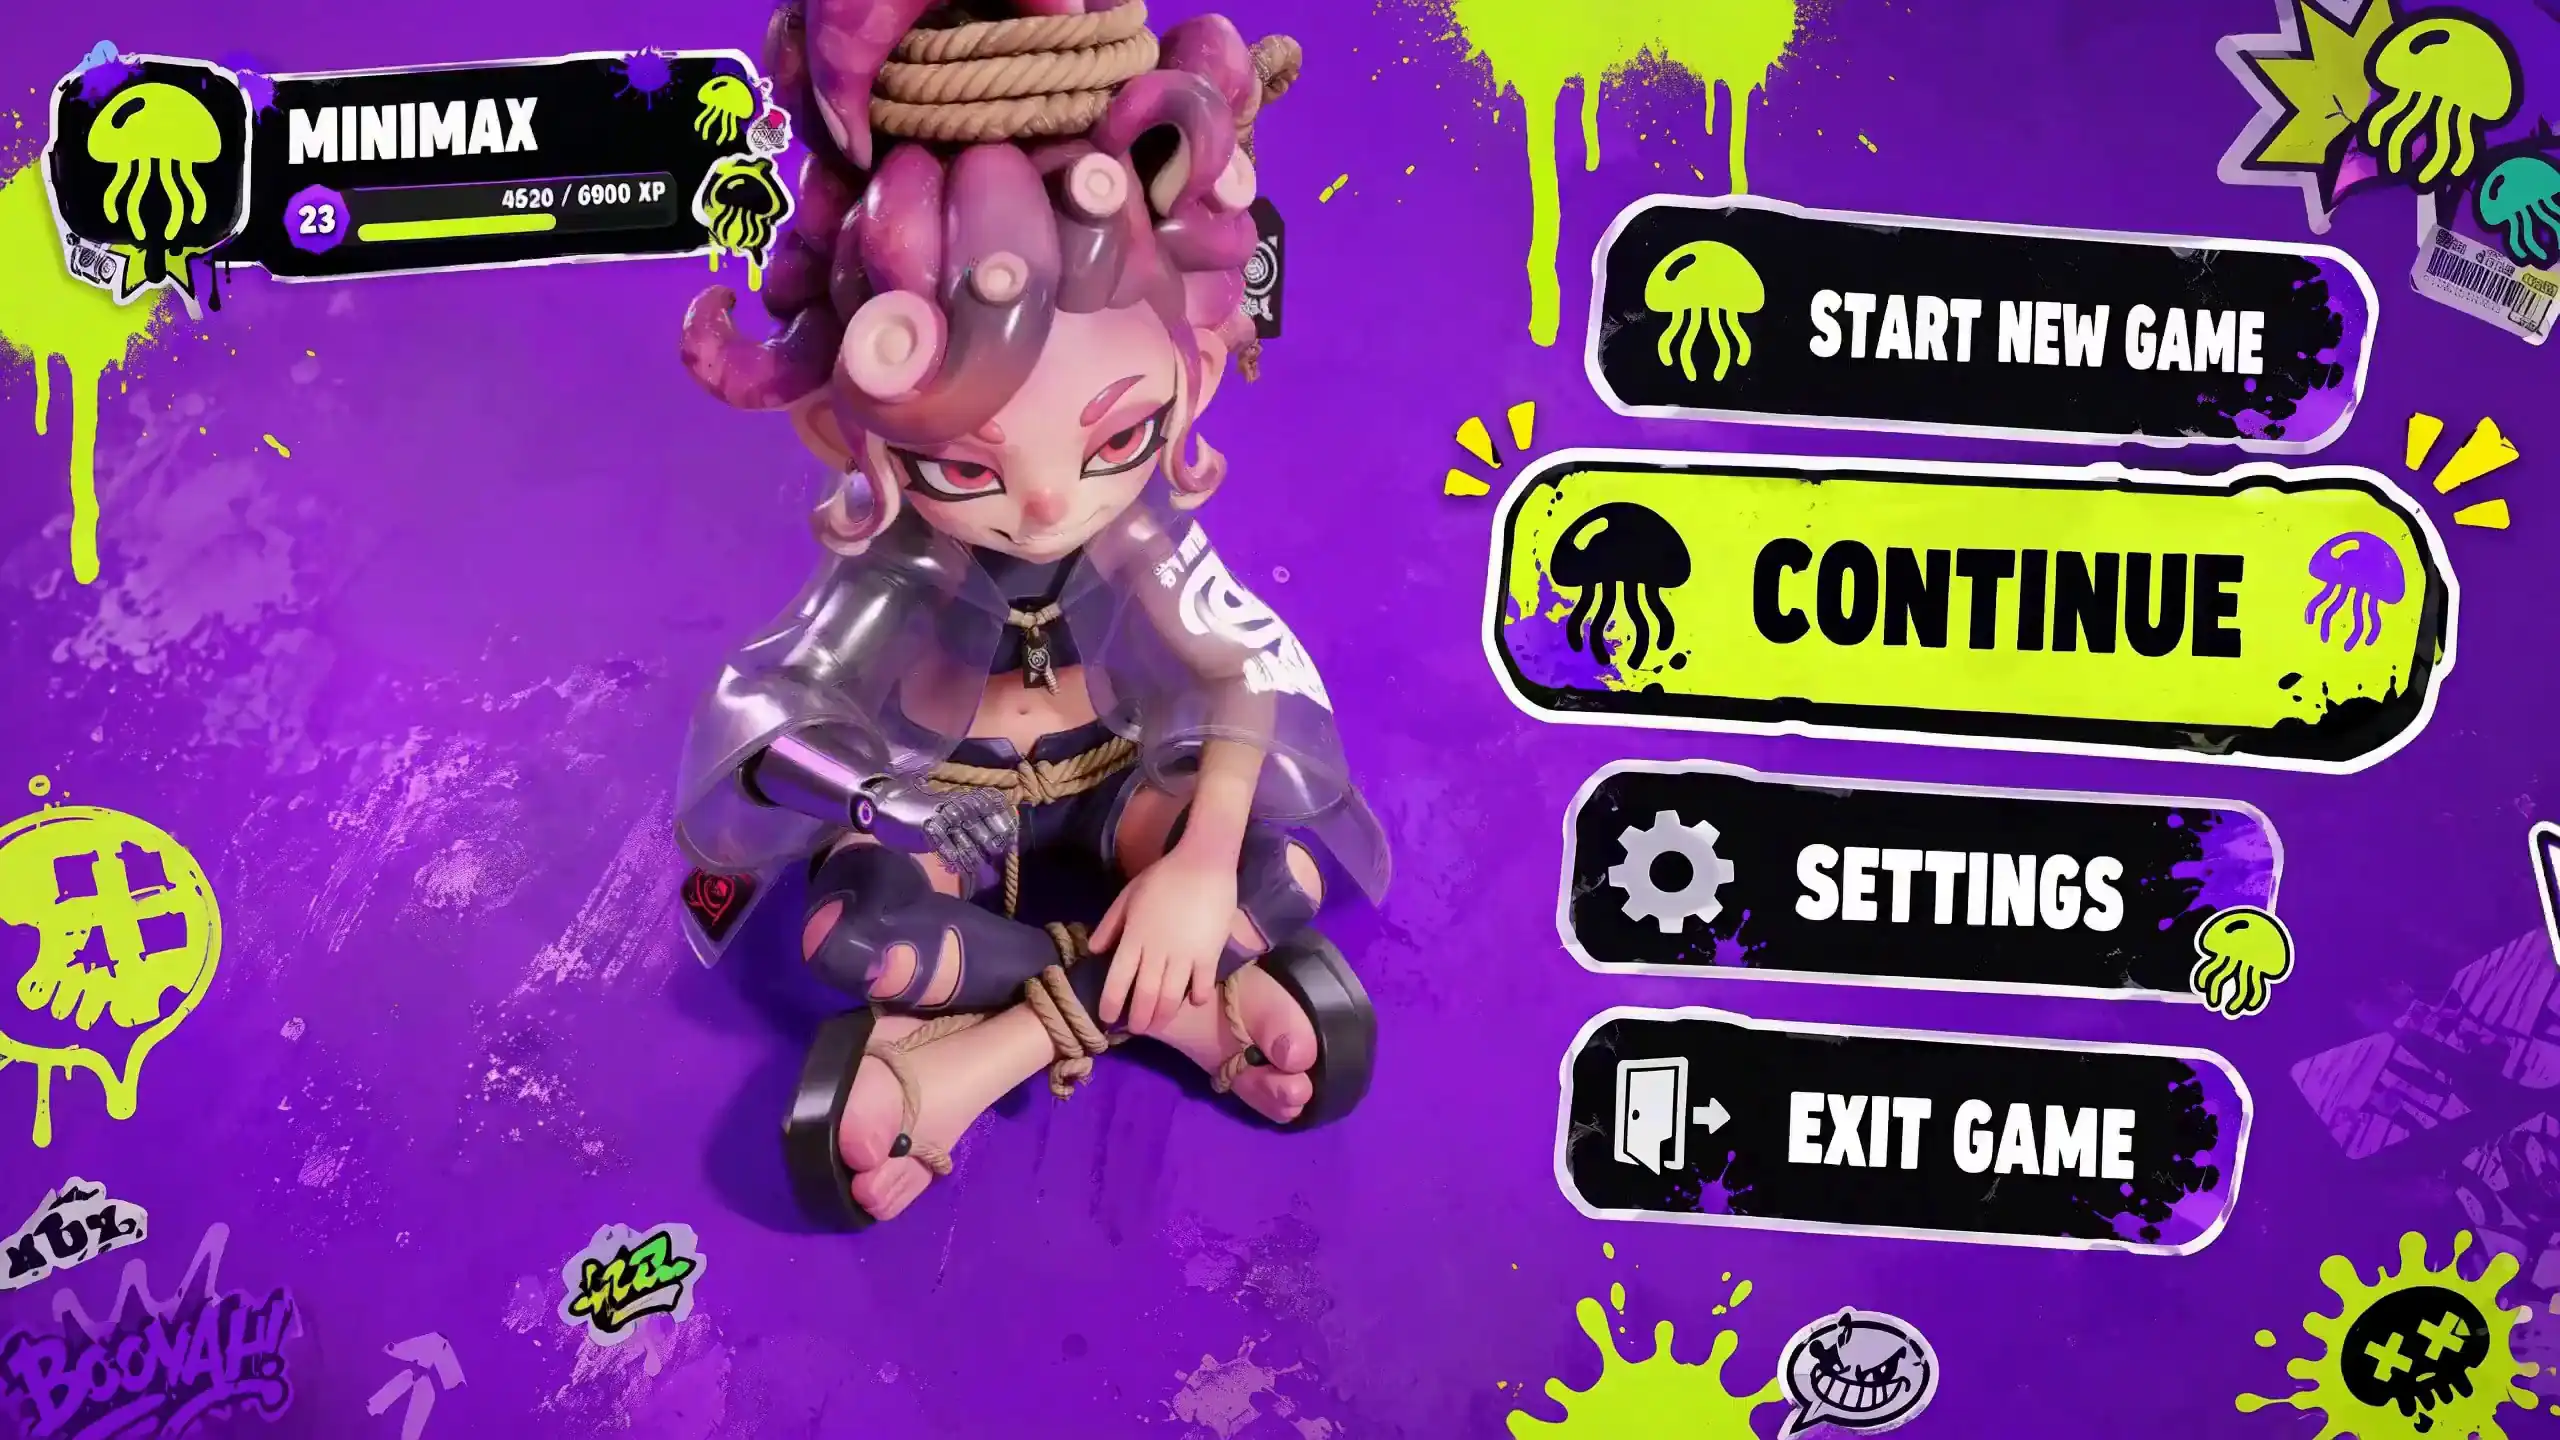
Eccelle nel seguire istruzioni, rendering preciso di testo e brand, e V2V motion transfer. Progettato per ads, product design, UI/UX e contenuti gaming.
Fine-tune, personalizza e distribuisci sul tuo hardware. Compatibile con un'ampia gamma di acceleratori IA — la compatibilità hardware era una considerazione chiave di design.
Scrivi un prompt o allega riferimenti multimodali, e MiniMax H3 genera video 2K con audio stereo nativo — dialogo, SFX e ambience in un solo passaggio.
Il design di generalizzazione dei task di MiniMax H3 offre ampie capacità multimodali dalla fase di pretraining.
Un transformer gestisce text-to-video, image-to-video, reference-to-video, video editing e audio generation — senza modelli T2V, I2V e TTS separati uniti.
Generazione congiunta video e audio in un forward pass a 32kHz stereo. Voce, effetti sonori e musica modellati congiuntamente — senza separazione tra domini audio.
Durate output da 4 a 15 secondi a 24 frames per second. Rapporti d'aspetto da 2:5 a 5:2, dal widescreen cinematografico ai formati verticali social.
Tokenizer completamente rinnovato con miglioramenti nella qualità di ricostruzione su tutti i fronti. 4x di guadagno in effective sequence length — tecnologia chiave dietro il supporto nativo 2K.
Supporta Arabic, Chinese, English, French, German, Italian, Japanese, Korean, Portuguese, Russian e altro — con diversi gradi di supporto lingua audio.
A 2K, il prezzo al secondo è meno di un terzo dei modelli mainstream (~0.80 CNY/sec). A 768p, meno della metà del prezzo delle offerte mainstream 720p.
Classificato come il modello IA più potente al mondo in video editing sui benchmark Artificial Analysis — solo dietro in T2V puro rispetto a Gemini e Seedance.
Dall'architettura omni-modale aperta di MiniMax H3 alla generazione di 30 secondi di Wan 3.0 e alla qualità cinematografica di Google Veo.
Modello omni-modale open-weight 33B con audio stereo 2K nativo e editing basato su istruzioni.
Brand consumer MiniMax per H3 — 2K nativo, audio sincronizzato e controllo omni-reference.
Modello video multimodale da 30 secondi di Alibaba con conversione document-to-video.
Video IA cinematografico Google DeepMind con 4K e audio nativo.
Approfondimenti su architettura H3, integrazione API e workflow creativi.
Hai ancora domande? Siamo qui per aiutarti.