Desarrolladores e integradores de API
Integra vía MiniMax API (`MiniMax-H3`), Vercel AI Gateway, fal.ai o self-host de pesos abiertos. Una sola arquitectura gestiona T2V, I2V, reference y editing.
MiniMax H3 es un sistema generativo omni-modal de propósito general — un modelo de 33B parámetros que comprende texto, imágenes, video y audio en contexto unificado, generando video 2K con sonido estéreo nativo en un solo forward pass.
MiniMax H3 rompe el dominio del código cerrado con pesos abiertos, una relación precio-rendimiento líder en la industria y una arquitectura de generalización de tareas diseñada para el ecosistema abierto.
Los pesos H3-Base se publican en Hugging Face bajo la MiniMax Community License — permitiendo uso comercial para organizaciones con ingresos inferiores a $20M. Construye versiones personalizadas en diversos hardware de IA.
Un Transformer denso de flujo único de 33B parámetros con ~20B parámetros activos en inferencia. Usa Qwen3-VL-32B como encoder, 3D multimodal RoPE y separa el cómputo de comprensión/generación para un 30% más de throughput de entrenamiento.
El lenguaje actúa como puente unificando tareas en forma abierta y descriptiva. Describe las relaciones entre el contexto multimodal y el video objetivo en lenguaje natural — H3 gestiona la comprensión full-modality.
En lugar de super-resolution convencional, H3 regenera su propia salida 768p in-context a 2K — recuperando detalles finos como texto pequeño que los upscalers no pueden restaurar.
Sigue estos pasos para empezar a generar con MiniMax H3 usando el generador de esta página o la MiniMax API.
Selecciona text-to-video para generación solo con prompt, first/last-frame para image-to-video, o reference-to-video para flujos omni-reference con hasta 12 archivos de entrada mixtos.
MiniMax H3 sirve a desarrolladores, estudios y creadores que necesitan video IA abierto, controlable y de grado producción con comprensión multimodal.
Integra vía MiniMax API (`MiniMax-H3`), Vercel AI Gateway, fal.ai o self-host de pesos abiertos. Una sola arquitectura gestiona T2V, I2V, reference y editing.
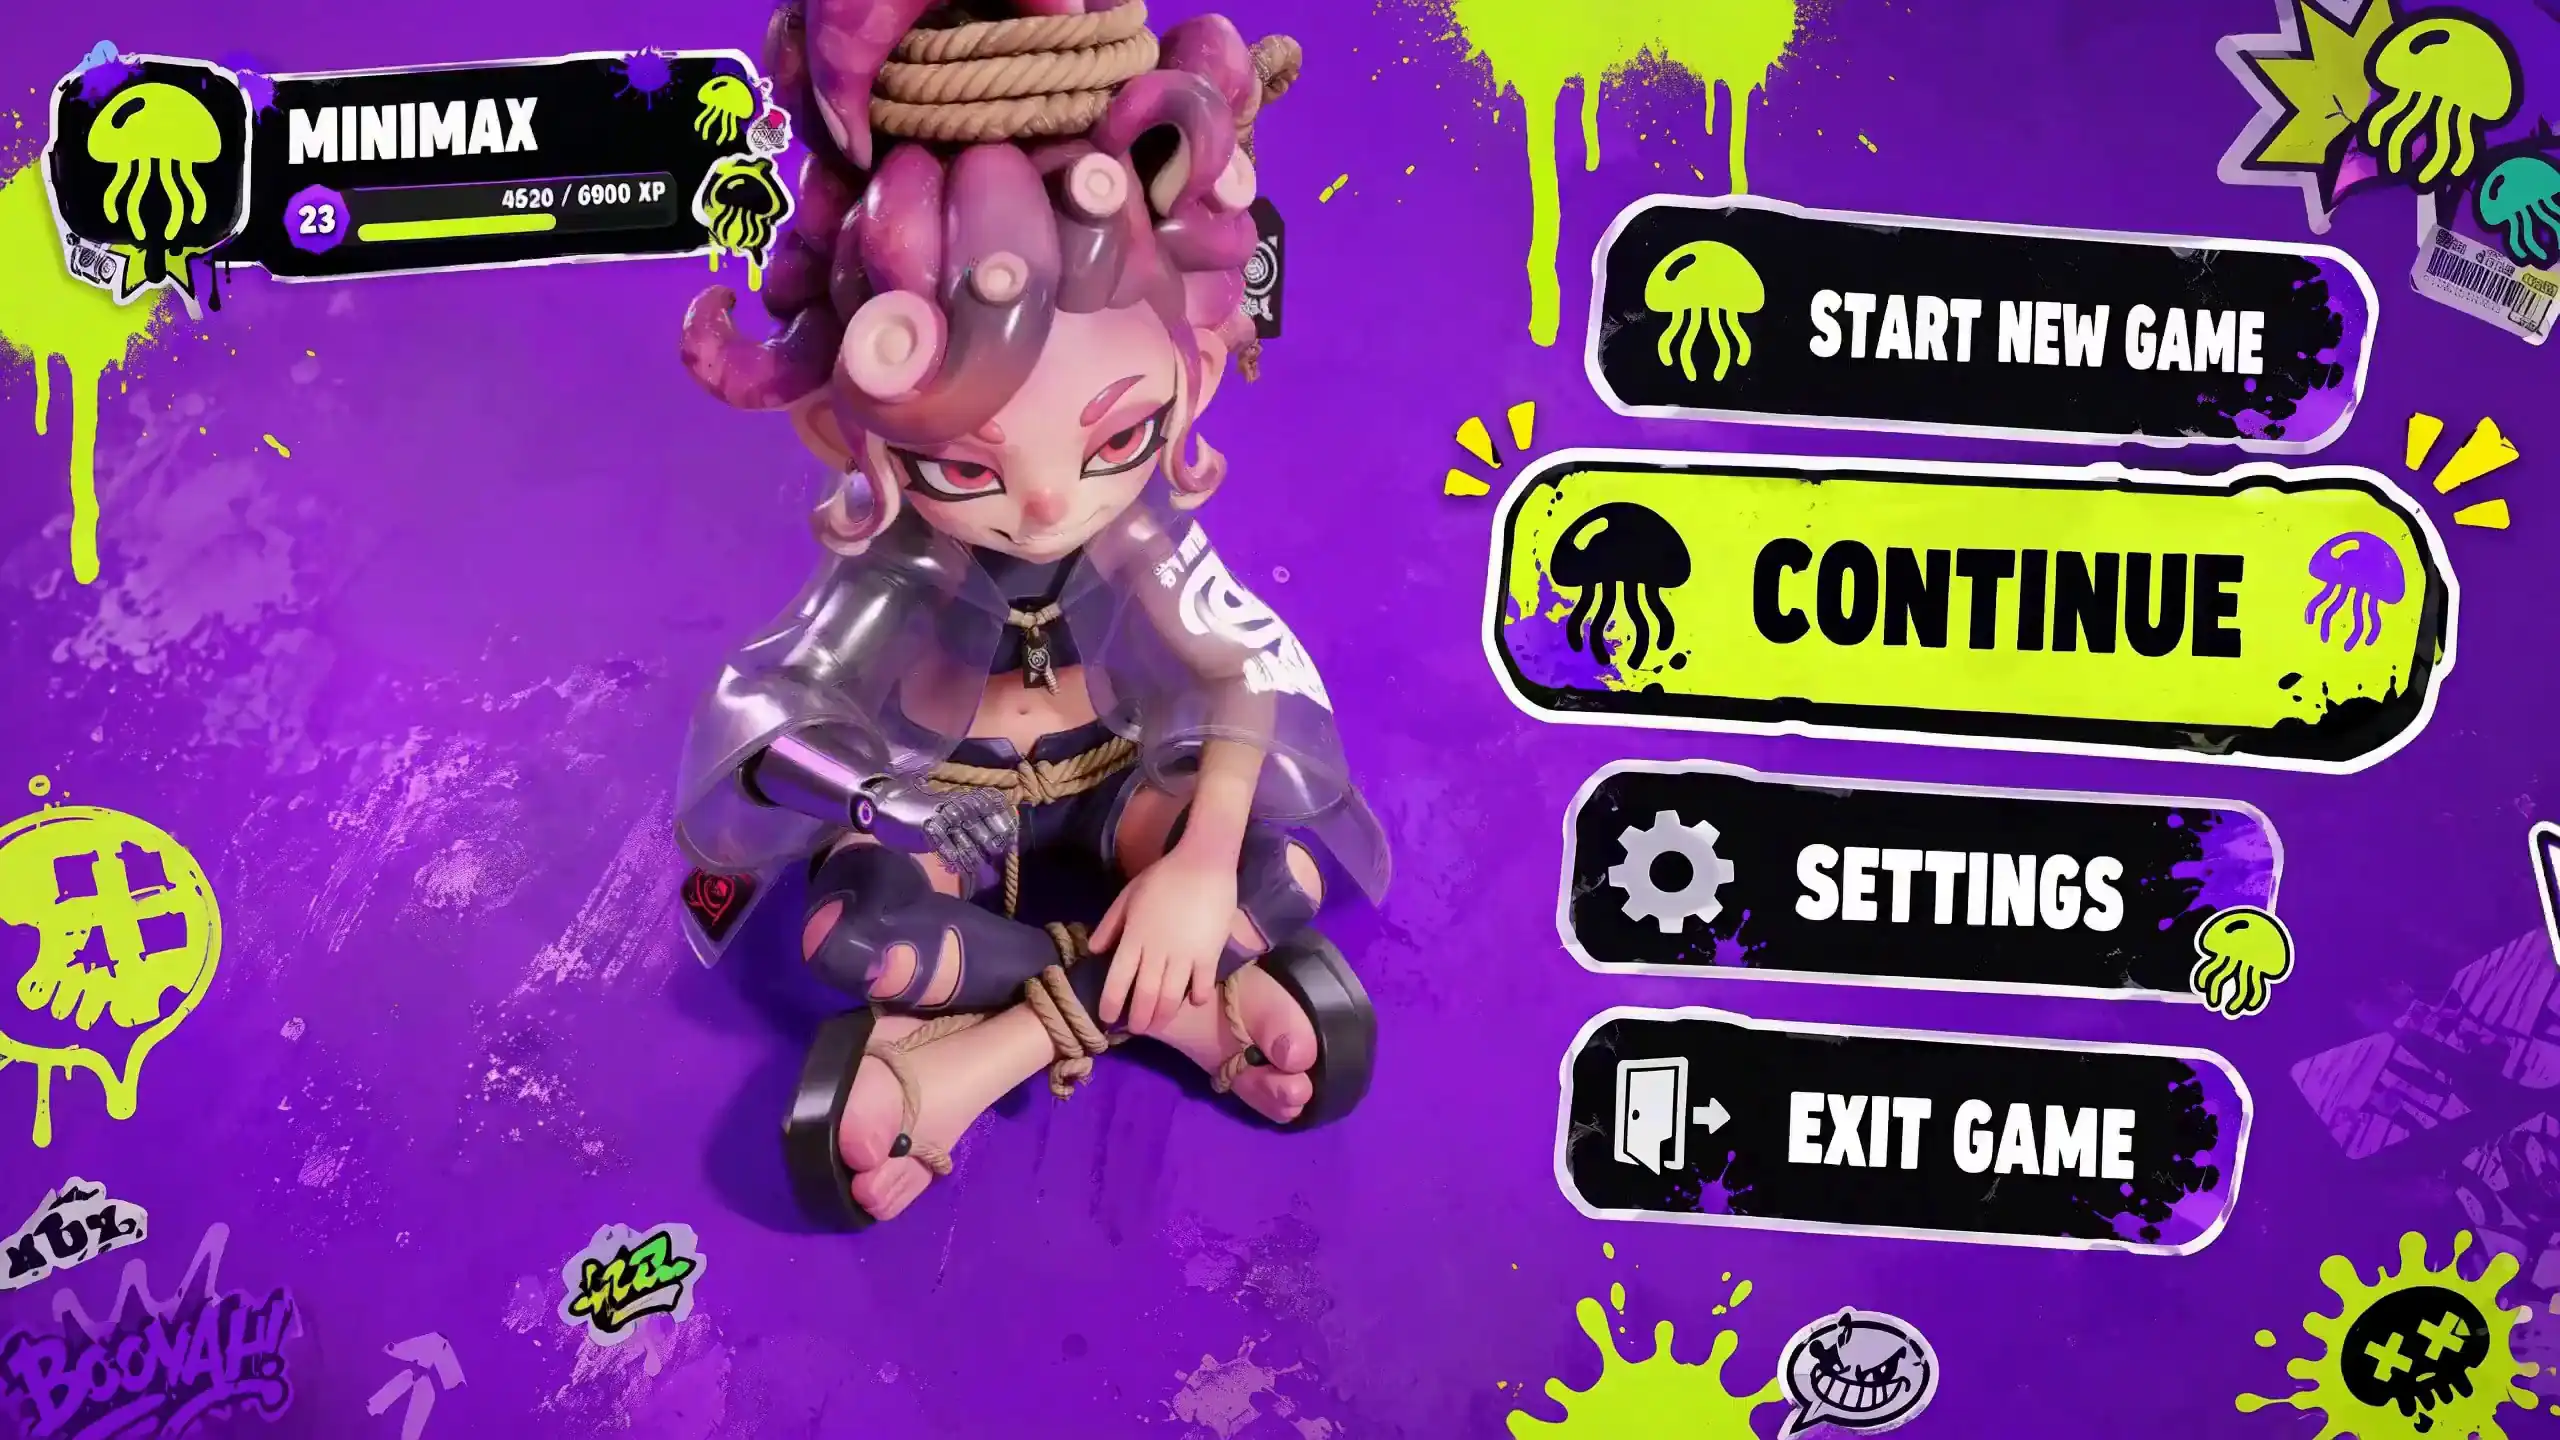
Destaca en seguimiento de instrucciones, renderizado preciso de texto y marca, y V2V motion transfer. Diseñado para anuncios, product design, UI/UX y contenido gaming.
Fine-tune, personaliza y despliega en tu propio hardware. Compatible con una amplia gama de aceleradores de IA — la compatibilidad de hardware fue una consideración clave de diseño.
Escribe un prompt o adjunta referencias multimodales, y MiniMax H3 genera video 2K con audio estéreo nativo — diálogo, SFX y ambience en un solo paso.
El diseño de generalización de tareas de MiniMax H3 ofrece amplias capacidades multimodales desde la etapa de pretraining.
Un transformer gestiona text-to-video, image-to-video, reference-to-video, video editing y audio generation — sin modelos T2V, I2V y TTS separados unidos.
Generación conjunta de video y audio en un forward pass a 32kHz stereo. Voz, efectos de sonido y música modelados conjuntamente — sin separación entre dominios de audio.
Duraciones de salida de 4 a 15 segundos a 24 frames per second. Relaciones de aspecto de 2:5 a 5:2, cubriendo formatos cinematográficos widescreen y verticales para redes sociales.
Tokenizer completamente renovado con mejoras en calidad de reconstrucción en todos los aspectos. 4x de ganancia en effective sequence length — tecnología clave detrás del soporte nativo 2K.
Soporta Arabic, Chinese, English, French, German, Italian, Japanese, Korean, Portuguese, Russian y más — con distintos grados de soporte de idioma de audio.
A 2K, el precio por segundo es menos de un tercio de los modelos mainstream (~0.80 CNY/sec). A 768p, menos de la mitad del precio de ofertas mainstream 720p.
Clasificado como el modelo IA más potente del mundo en video editing en benchmarks de Artificial Analysis — solo por detrás en T2V puro frente a Gemini y Seedance.
Desde la arquitectura omni-modal abierta de MiniMax H3 hasta la generación de 30 segundos de Wan 3.0 y la calidad cinematográfica de Google Veo.
Modelo omni-modal open-weight de 33B con audio estéreo 2K nativo y edición basada en instrucciones.
Marca consumer de MiniMax para H3 — 2K nativo, audio sincronizado y control omni-reference.
Modelo de video multimodal de 30 segundos de Alibaba con conversión document-to-video.
Video IA cinematográfico de Google DeepMind con 4K y audio nativo.
Profundiza en la arquitectura de H3, integración API y flujos creativos.
¿Aún tienes preguntas? Estamos aquí para ayudarte.